Раздел 2 · 3 балла
EDA: рассматриваем данные
Разбираем графики, которые Colab строит сам, отделяем полезные от бесполезных, придумываем гипотезу и строим свой график, чтобы её проверить.
- EDA
- Разведочный анализ данных: первый осмотр таблицы глазами и графиками, до всяких моделей.
- Гипотеза
- Предположение, которое можно проверить данными. Например: «семьи с детьми тратят меньше».
- Гистограмма
- Столбики: сколько клиентов попало в каждый интервал значений.
- Scatter
- Точечный график: каждый клиент это точка, по осям два его свойства.
- Выброс
- Значение, которое резко отличается от остальных. Пример: доход 666666 при обычных 30-80 тыс.
- Медиана
- Середина: половина значений меньше, половина больше. Выбросы на неё почти не влияют, в отличие от среднего.
Графики Colab: что полезно, что нет
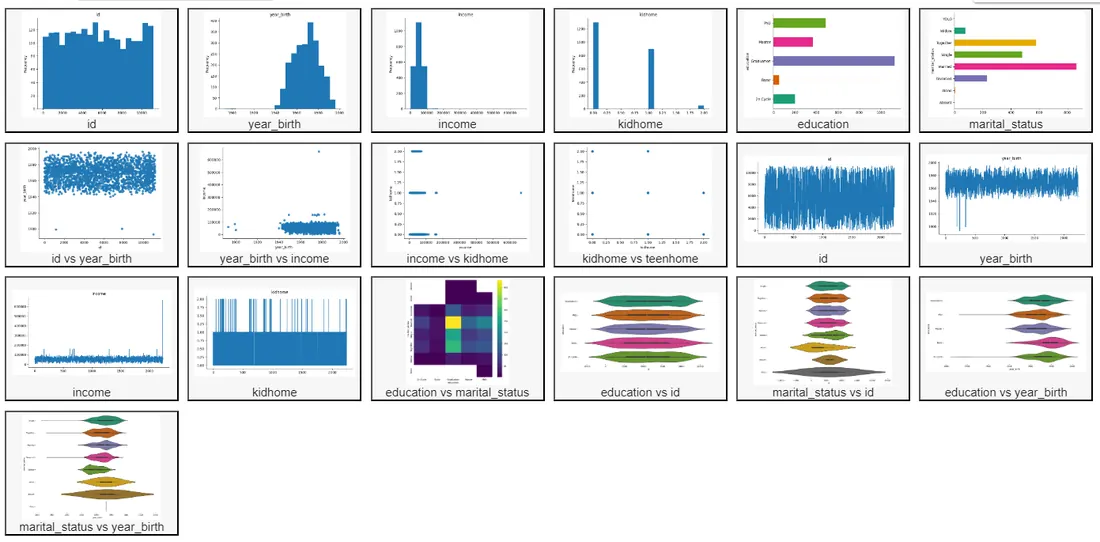
year_birth и income (видны выбросы) и столбики образования и семейного положения. Всё с id и все линии «по номеру строки» это шум.
| Бесполезные | Почему |
|---|---|
Всё с id (гистограмма id, id vs year_birth, education vs id) | id это номер, а не величина. Клиент №5 не «меньше» клиента №6 |
| Линии «по номеру строки» (id, income, mntwines...) | Порядок строк в файле случайный, соединять соседей линией бессмысленно |
kidhome vs teenhome, гистограмма kidhome | Всего 3 значения (0, 1, 2), точки лежат друг на друге |
| Scatter целых количеств покупок | Сетка точек, не видно, где их много |
| Полезные | Что видно |
|---|---|
Гистограммы year_birth, income | Выбросы: годы рождения около 1893-1900, доход 666666 |
Столбики education, marital_status | Больше всего Graduation и Married; странные категории Alone (3), Absurd (2), YOLO (2) |
Гистограммы трат mnt... | Большинство тратит мало, немногие очень много |
| Scatter трат друг против друга | Положительная связь между категориями |
year_birth vs income | Возраст почти не влияет на доход |
Гипотеза
Клиенты с детьми тратят в магазине заметно меньше, чем без детей. Возможная причина: у семей с детьми ниже доход. Чтобы это проверить, строим новый график, которого у Colab нет: траты в зависимости от числа детей.
- Boxplot (ящик с усами)
- Линия в коробке = медиана; коробка = средняя половина клиентов; усы = обычный разброс; отдельные кружки = выбросы.
spend_cols = ['mntwines', 'mntfruits', 'mntmeatproducts',
              'mntfishproducts', 'mntsweetproducts', 'mntgoldprods']

eda = pd.merge(people, products, on='id')
eda['total_spent'] = eda[spend_cols].sum(axis=1)       # сколько клиент потратил всего
eda['children'] = eda['kidhome'] + eda['teenhome']     # всего детей и подростков дома
eda = eda[eda['income'] < 200000]                      # убираем выброс income = 666666

fig, axs = plt.subplots(1, 2, figsize=(14, 5))
sns.boxplot(data=eda, x='children', y='total_spent', hue='children',
            palette='viridis', legend=False, ax=axs[0])
...  # подписи осей и заголовок
sns.scatterplot(data=eda, x='income', y='total_spent', hue='children',
                palette='viridis', s=15, ax=axs[1])
...
plt.show()
print(eda.groupby('children')[['total_spent', 'income']].median())
pd.merge(people, products, on='id')склеиваем анкету и траты по номеру клиента. Здесь можно: запрет на join был только в разделе pandas/SQL.eda[spend_cols].sum(axis=1)складываем 6 трат в каждой строке (axis=1= «вдоль строки»). Получаем общую сумму трат клиента.kidhome + teenhomeвсего детей и подростков дома: от 0 до 3.eda[eda['income'] < 200000]убираем выброс 666666, иначе ось доходов растянется и всё сожмётся в угол.plt.subplots(1, 2)холст на две картинки рядом:axs[0]левая,axs[1]правая.sns.boxplot(x='children', y='total_spent')по ящику трат на каждое число детей.sns.scatterplot(x='income', y='total_spent', hue='children')точка на клиента, цвет = число детей.groupby('children')[...].median()медиана трат и дохода для каждого числа детей.
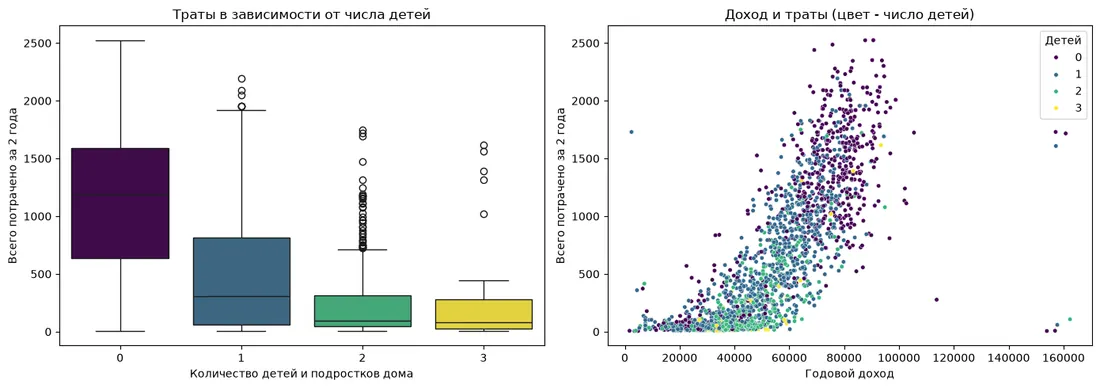
| Детей дома | Медиана трат | Медиана дохода |
|---|---|---|
| 0 | 1189 | 72190 |
| 1 | 306 | 47216 |
| 2 | 94 | 44065 |
| 3 | 80 | 44277 |
Вывод
- Гипотеза подтверждается: без детей медиана трат 1189, с одним ребёнком 306 (в 4 раза меньше), с двумя-тремя 80-94.
- Доход у бездетных тоже выше (72 тыс. против 44-47 тыс.), так что часть разницы объясняется деньгами.
- Но не вся: среди клиентов с одинаковым доходом 60-80 тыс. медиана трат 1289 без детей и 960 с одним ребёнком. Значит, дети уменьшают траты и сами по себе.
Вопросы на защите
Какие графики Colab бесполезны и почему?
Всё с id (это номер, а не величина) и линии по номеру строки (порядок строк ничего не значит).
Почему медиана, а не среднее?
Траты сильно скошены: несколько клиентов тратят огромные суммы и тянут среднее вверх. Медиана показывает «типичного» клиента.
Зачем убрал доход больше 200000?
Там выброс 666666. Он растягивает ось и сплющивает график, а на вывод не влияет.
Чем твой график отличается от графиков Colab?
Colab строит графики по одной таблице и по исходным столбцам. Я сложил новые признаки (общие траты, число детей) из двух таблиц и сравнил группы ящиками.