Раздел 4 · 1 балл
Кластеры и снижение размерности
Готовый kMeans из sklearn делит клиентов на группы по тратам. Мы выбираем число групп, рисуем их на плоскости тремя способами и объясняем, кто в какой группе. Писать тут почти ничего не нужно, балл дают за объяснение.
- Кластер
- Группа похожих объектов.
- Кластеризация
- Деление объектов на группы, когда правильных ответов никто не дал.
- Обучение без учителя
- У данных нет «правильных меток», алгоритм ищет структуру сам. kNN выше был «с учителем»: доходы соседей известны.
- Центроид
- Центр кластера: среднее всех его точек.
Сколько групп брать
Ноутбук запускает kMeans для k от 2 до 14 и смотрит на две оценки.
- Инерция (SSE)
- Сумма квадратов расстояний от каждого клиента до центра его группы. Меньше = группы плотнее.
- Метод локтя
- Ищем k, после которого инерция перестаёт сильно падать: график сгибается, как рука в локте.
- Силуэт
- Оценка от −1 до 1: насколько клиент ближе к своей группе, чем к соседней. Ближе к 1 = группы чётче.
Формула силуэта для одного клиента: a = среднее расстояние до своих, b = среднее расстояние до ближайшей чужой группы.
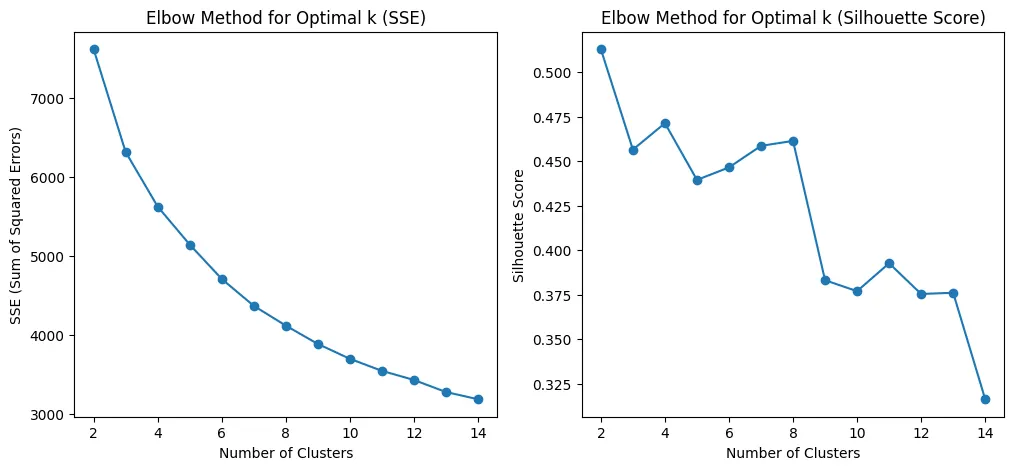
- Инерция падает всегда: чем больше флажков, тем ближе каждый к своему. Поэтому «где меньше» не подходит, ищут излом.
- k=2 даёт лучший силуэт, но это грубое деление «тратит мало / тратит много».
- k=4 следующий пик силуэта, и группы получаются осмысленными. Его и берём.
- k-means++
- Умный старт: начальные флажки ставятся подальше друг от друга.
- n_init=10
- 10 запусков с разных стартов, берётся лучший (с наименьшей инерцией).
- random_state=42
- Фиксирует случайность, чтобы при повторном запуске получился тот же результат.
Снижение размерности: как нарисовать 6 признаков
У каждого клиента 6 чисел трат, а экран плоский. Методы снижения размерности сжимают 6 чисел до 2-3 так, чтобы картинка как можно меньше врала.
| Метод | Как работает | Что сохраняет |
|---|---|---|
| PCA | Линейный: поворачивает облако и смотрит вдоль направлений самого большого разброса | Общую форму, расстояния вдоль главных осей |
| t-SNE | Нелинейный: старается, чтобы соседи остались соседями | Локальную структуру (кто рядом с кем) |
| UMAP | Нелинейный, похож на t-SNE, но опирается на топологию | И соседей, и лучше общую картину |
- Линейный
- Только поворачивает и сплющивает, не гнёт. Нелинейный может «разгибать» облако.
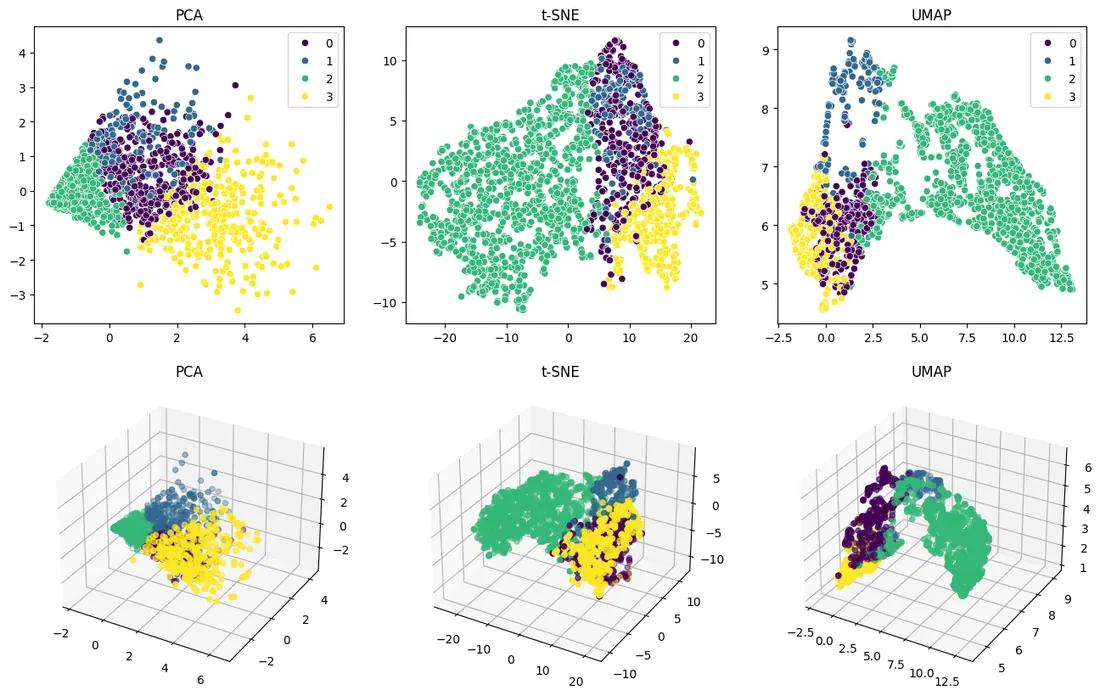
- PCA: первая ось по сути «сколько всего тратит». Слева плотная куча экономных, правее остальные, и они перекрываются.
- t-SNE: экономные отдельным большим облаком, три активных кластера рядом, граница между ними размыта.
- UMAP: группы разделены чётче всего.
- 3D почти ничего не добавляет: точки закрывают друг друга.
- Общий вывод: в данных есть одна резкая граница (мало тратит / много тратит), а деление активных на три группы есть, но мягкое.
Кто в каких группах
Средние траты в каждой группе (номера из запуска в Colab):
| Кл. | Людей | Вино | Фрукты | Мясо | Рыба | Сладкое | Золото |
|---|---|---|---|---|---|---|---|
| 2 | 1297 | 96 | 6 | 35 | 9 | 6 | 17 |
| 0 | 392 | 717 | 36 | 367 | 53 | 35 | 40 |
| 1 | 206 | 476 | 26 | 171 | 32 | 26 | 144 |
| 3 | 345 | 512 | 91 | 432 | 130 | 96 | 90 |
| все | 2240 | 304 | 26 | 167 | 38 | 27 | 44 |
| Группа | Портрет |
|---|---|
| 2 · экономные | Больше половины клиентов, тратят мало на всё |
| 0 · вино + мясо | Вино 717 (в 2.4 раза выше среднего), мясо тоже высокое, остального мало |
| 1 · любители золота | Золото 144, втрое выше среднего |
| 3 · гурманы | Много тратят на всё: фрукты, рыбу, сладости в 3 с лишним раза выше среднего |
«Есть ли кластер любителей вина?» (вопрос из ноутбука). Да, с оговоркой: в группе 0 траты на вино самые высокие среди всех групп, а на фрукты, рыбу и сладости низкие. Но мясо там тоже выше среднего, поэтому честнее «вино + мясо».
Вопросы на защите
Почему k = 4?
Явного локтя у инерции нет. Силуэт при k=4 даёт локальный пик (0.471), а группы хорошо описываются словами. k=2 даёт только «мало / много».
Почему инерция всегда падает с ростом k?
Больше центров → каждая точка ближе к своему центру. В пределе, когда центр у каждой точки свой, инерция 0. Поэтому по ней ищут излом, а не минимум.
Чем PCA отличается от t-SNE и UMAP?
PCA линейный, только поворачивает и сплющивает. t-SNE и UMAP нелинейные, сохраняют соседей и лучше показывают группы, но расстояния между группами на их картинках не настоящие.
Зачем StandardScaler перед kMeans?
kMeans тоже считает расстояния. Без масштаба вино (до 1493) и мясо (до 1725) задавили бы фрукты (до 199) и сладости.
Зачем n_init=10?
kMeans может застрять в плохом решении в зависимости от старта. 10 запусков и выбор лучшего это страховка.