Раздел 5 · 4 балла
Свой kMeans
Пишем kMeans сами в три шага: функция «к какому центру ближе», цикл «передвинуть центры», и всё вместе с условием остановки. Проверяем на игрушечных точках, где правильный ответ известен.
Игрушечные данные
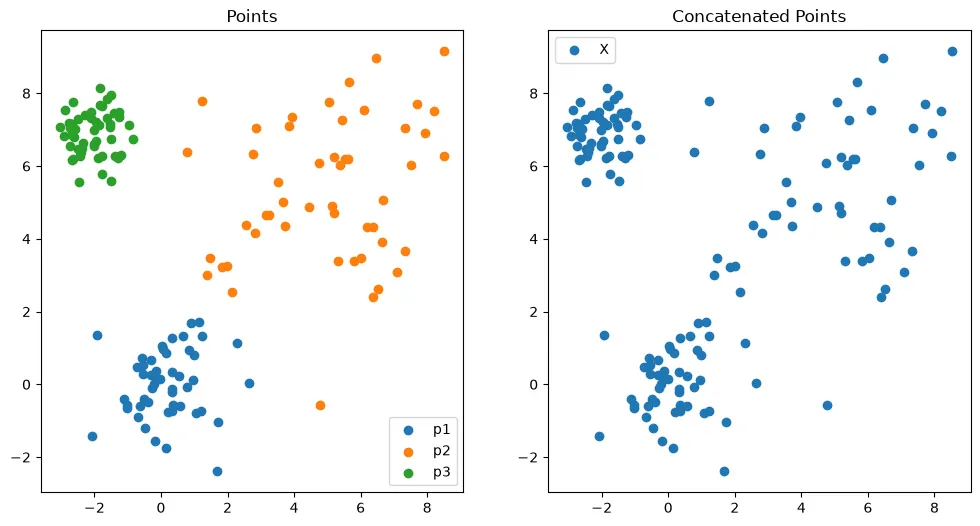
Ноутбук сам генерирует 3 облака по 50 точек на плоскости:
| Облако | Центр | Разброс |
|---|---|---|
| p1 | (0, 0) | 1 |
| p2 | (5, 5) | 2 (самое размазанное) |
| p3 | (3, 3) − (5, −4) = (−2, 7) | 0.6 (самое плотное) |
- np.random.normal(loc, scale, size)
- Случайные точки вокруг
locс разбросомscale, как выстрелы вокруг центра мишени.
Попробуй руками
Тот же алгоритм прямо здесь. Нажимай «Шаг» и смотри, как красные крестики (центры) едут к облакам. Иногда при неудачном старте два облака склеиваются в один кластер, тогда нажми «Новый старт».
Старт: 3 центра поставлены случайно.
Подпункт 1: kmeans_predict
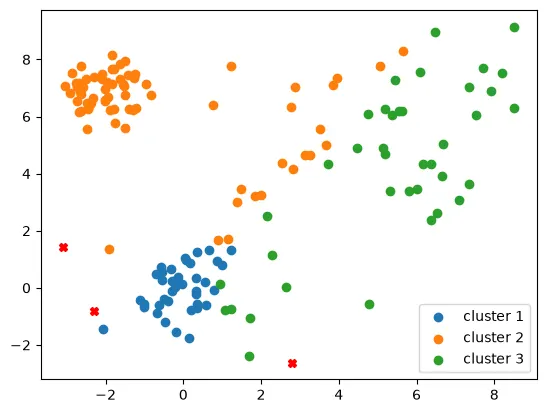
Идея: для каждой точки посчитать расстояние до каждого центра и выбрать ближайший.
import scipy
from scipy.spatial.distance import cdist


def kmeans_predict(X, clusters):
    # расстояния от каждой точки до каждого центра: таблица (число точек) x (число центров)
    distances_to_centers = cdist(X, clusters)
    # номер ближайшего центра для каждой точки
    labels = distances_to_centers.argmin(axis=1)
    return labels
cdist(X, clusters)таблица 150 × 3: строка = точка, столбец = центр, в клетке расстояние..argmin(axis=1)в каждой строке номер самого маленького числа, то есть номер ближайшего центра (0, 1 или 2).return labels150 номеров. Метка (label) = номер кластера точки.
Пример: точка (1, 1), центры (0, 0), (5, 5), (−2, 4).
Подпункт 2: обновление центров
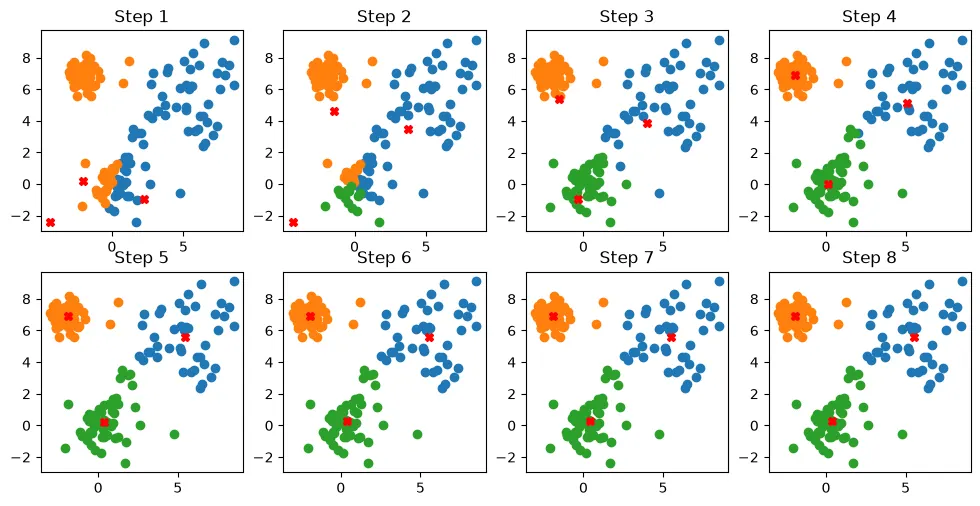
Идея: каждый центр переносим в среднее своих точек и так 7 раз, каждый раз запоминая центры для картинки.
for i in range(iters):
    labels = kmeans_predict(X, centroids)
    new_centroids = centroids.copy()
    for j in range(k):
        if np.any(labels == j):  # если в кластер не попало ни одной точки, центр не двигаем
            new_centroids[j] = X[labels == j].mean(axis=0)
    centroids = new_centroids
    centroids_history.append(centroids)
labels = kmeans_predict(...)каждая точка выбирает ближайший центр.centroids.copy()копия, чтобы не испортить старые центры: они уже лежат в истории.for j in range(k)по очереди для каждого из 3 кластеров.labels == jмаска «точки кластера j».np.any(...)есть ли в кластере хоть одна точка. Среднее пустого множества посчитать нельзя.X[labels == j].mean(axis=0)среднее точек кластера: отдельно по x и по y (axis=0= вниз по столбцам). Это новый центр.centroids_history.append(...)сохраняем кадр.
Подпункт 3: kmeans_fit_predict
| Параметр | Смысл |
|---|---|
k | Сколько кластеров (у нас 3) |
max_iter | Максимум повторов (100), чтобы цикл точно закончился |
tol | Порог: если центры суммарно сдвинулись меньше 0.001, хватит |
low, high | В каком диапазоне ставить случайные стартовые центры |
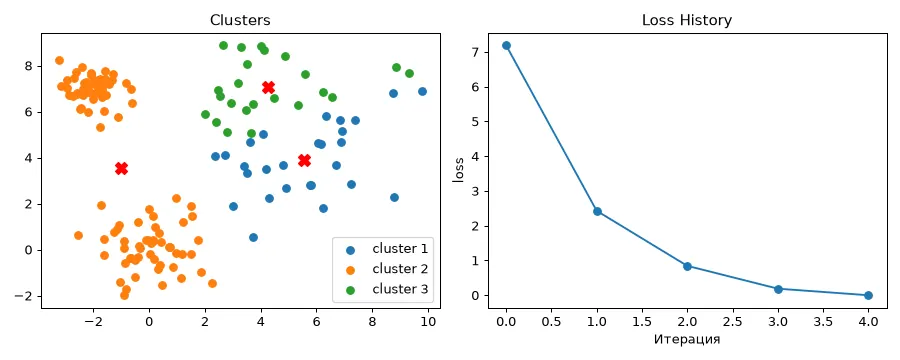
loss здесь означает «на сколько суммарно сдвинулись центры за шаг». Пока центры едут, loss большой; когда встали, loss = 0.
def kmeans_fit_predict(x, k=8, max_iter=100, tol=0.001, low=0.0, high=1.0, print_progress=False):
    n_features = x.shape[1]
    clusters = np.random.uniform(low, high, size=(k, n_features))  # случайные стартовые центры
    loss_history = []

    for i in range(max_iter):
        labels = cdist(x, clusters).argmin(axis=1)

        new_clusters = np.empty_like(clusters)
        for j in range(k):
            points = x[labels == j]
            if len(points) > 0:
                new_clusters[j] = points.mean(axis=0)
            else:
                new_clusters[j] = np.random.uniform(low, high, size=n_features)

        loss = np.linalg.norm(new_clusters - clusters, axis=1).sum()
        loss_history.append(loss)
        if print_progress:
            print(f'Итерация = {i}, loss = {loss}')

        clusters = new_clusters
        if loss < tol:  # центры почти не двигаются: алгоритм сошёлся
            break

    labels = cdist(x, clusters).argmin(axis=1)  # метки для финальных центров
return clusters, labels, loss_historyx.shape[1]сколько координат у точки (у нас 2).np.random.uniform(low, high, size=(k, 2))k случайных центров, любое число от low до high одинаково вероятно.cdist(...).argmin(axis=1)то же, чтоkmeans_predict: каждая точка к ближайшему центру.np.empty_like(clusters)заготовка под новые центры такой же формы.if len(points) > 0 ... else ...если кластер пуст, по условию даём ему новый случайный центр, чтобы он снова «поймал» точки.new_clusters - clustersна сколько сдвинулся каждый центр по x и y.np.linalg.norm(..., axis=1)длина сдвига каждого центра (тот же Пифагор)..sum()складываем по всем центрам.if loss < tol: breakцентры встали: выходим из цикла раньше.- После цикла ещё раз считаем метки, чтобы они точно соответствовали финальным центрам.
Пример вывода (у тебя числа будут другие, старт случайный):
Итерация = 0, loss = 5.265
Итерация = 1, loss = 5.256
Итерация = 2, loss = 2.128
Итерация = 3, loss = 1.059
Итерация = 4, loss = 0.187
Итерация = 5, loss = 0.0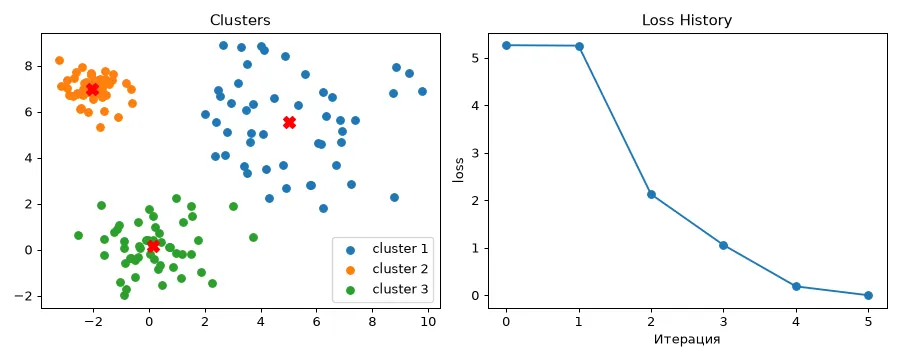
Вопросы на защите
Почему алгоритм обязательно остановится?
Каждый шаг не увеличивает сумму квадратов расстояний, а вариантов разбиения конечное число, поэтому центры рано или поздно встают (loss < tol). На всякий случай есть ещё max_iter.
Почему каждый запуск даёт разный результат?
Стартовые центры случайные (np.random.uniform), от старта зависит, куда придёт алгоритм.
Чем твой kMeans хуже sklearn?
Один запуск со случайного старта. В sklearn умный старт k-means++, 10 запусков (n_init) с выбором лучшего, и код быстрее.
Что делать с пустым кластером?
В подпункте 2 центр оставляем на месте, в подпункте 3 по условию задания даём ему новый случайный центр.
Что такое tol?
Порог остановки (0.001). Если центры суммарно сдвинулись меньше него, считаем, что алгоритм сошёлся.